Projetinho - parte 3
No post anterior, terminamos com o seguinte desenho:
Uma caixinha escrito price-ingester não quer dizer que vamos ter uma máquina
para fazer todo o trabalho. Normalmente isso representa um cluster o desenho a seguir
se aproxima mais da realidade.
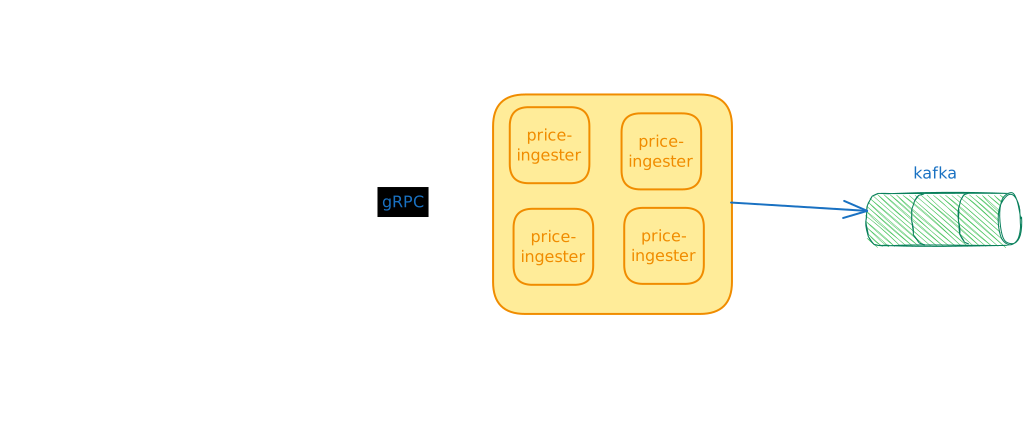
O desenho acima, no entanto, não é a única forma de organizar o processamento. Sabe o ditado “Não coloque todos os ovos na mesma cesta”? Vamos usá-lo aqui.
Imagine que o projeto tem todo aquele volume que foi calculado lá no começo, 240k rps.
Poderíamos ter um cluster gigantesco para suportar todo o tráfego. A vantagem é que a infra estrutura é mais simples para gerenciar. A desvantagem é que se o cluster cair, o app cai em todo o território nacional.
E se dividirmos em dois clusters? Um para uma metade do país e outro para a outra metade?
O risco diminui.
Poderíamos também ter um cluster por estado. E o tamanho do cluster pode ser variável.
Imagine um cluster para o estado de Roraima (636.707 habitantes no censo de 2022) e outro para o estado de São Paulo (44.411.238 habitantes). Claramente o número de máquinas em cada cluster é bem diferente.
Diga pra mim: Se você tem um cluster pra cada estado, sendo o menor com 10 máquinas e o maior com 600 máquinas, por qual deles você começaria a fazer um deploy?
Essas hipóteses são somente um exercício mental sobre escala. No nosso próximo episódio voltaremos a discutir o restante da solução.
Em breve, parte 4.